自作RDBにRaftを実装して分散データベースにしてみた
- はじめに
- Raftについて
- 3つの状態
- リーダー
- フォロワー
- 候補者
- 障害が起こると
- リーダー障害
- フォロワー障害
- ネットワークパーティション
- term
- 3つの状態
- simpledb-goでの設計方針
- Raftログエントリの構造
- ローカルWALとの関係
- 実装
- リーダー選出
- 投票リクエストの処理
- 投票で失敗するケース
- データ複製のシーケンス
- フォロワー側のログ取り込み
- FSM(Finite State Machine)
- 障害シナリオ
- 1. リーダーのネットワーク障害
- 2. 過半数に複製される前にリーダー死亡
- 3. 過半数に複製が成功したがクライアントへのレスポンス前にリーダー死亡
- 他にも...
- 実際に動かしてみる
- やってみて気づいたこと
- リーダーとフォロワーでリカバリの仕組みが違う
- ノード構成は起動時に決め打ち
- エッジケースの山
- 理解しやすさ
- スケーラビリティの限界
- Redisとの比較
- TCPとの共通点
- 検証の難しさ
- Raftの設計の巧みさ
はじめに
前回・前々回の記事ではDatabase Design and Implementation: Second EditionをもとにGoで自作RDB simpledb-go を実装し、B-treeインデックスによる読み取り性能の向上を確認しました。
今回はこのDBにRaftコンセンサスアルゴリズムを実装し、複数ノードで動く分散データベースに拡張してみます。
これまで作ってきたシングルノードのRDBでもデータの一貫性はありますが、そのノードが死んだら終わりです。単純にノードを増やすだけでは、ノード間でデータがずれて一貫性が崩れてしまいます。Raftを使った分散DBでは、過半数のノードによる合意を通じて全ノードのログを同じ順序に保つことで、一貫性を維持したままノード障害への耐性を得られます。
Raft実装はetcdやHashiCorpによる既存ライブラリもありますが、内部を理解するためAIの力を大いに借りつつsimpledb-goの中に実装しました。以降長々と解説が続きますが、動いている様子が見たい方は実際に動かしてみるまで飛んでください。
続きを読む自作DBのB-treeインデックスがどれくらい効くのか計測してみた
はじめに
前回はDatabase Design and Implementation: Second EditionをもとにGoで再実装したsimpledb-goについて紹介しました。このDBには簡素なB-treeインデックスを実装したため、今回は実際に読み取り性能がどれくらい向上するのか計測してみました。せっかくインデックスを作ったからには、ちゃんと効果を確認したいところです。
ベンチマークツールを作成し、インデックスの有無によるSELECT性能の違いを調べていきます。
simpledb-goのインデックス
まずsimpledb-goに実装してあるB-tree Indexについて簡単に触れておきます。B-tree Indexとは複数の枝が生えたツリー構造を利用し、DBの実データが保管されている場所を高速に検索するために使われる索引構造のことです。
業務でデータベースを触っているとB+treeという名前を聞くことの方が多いかもしれません。
それぞれの詳細な説明はwikipediaに任せるとしますが、2つのページに分かれていることからも分かる通りB-treeとB+treeは別物です。
別物ですが、DB文脈でB-treeと言うとB+treeを指すことが多いようです。B-treeは全てのノードにインデックスのキー値、下層ノードあるいはリーフへのポインタ、実データへのポインタを保存するのに対し、B+treeでは実データへのポインタはリーフノードにしか保持しません。さらにB+treeではリーフノード同士は連結リストになっている、という点も異なっています。
ではsimpledb-goのインデックスはどうなのかというと、現状ではリーフノードにしか実データへのポインタを保持せず、リーフノード同士は連結されていません。つまりB-treeでもB+treeでもありません。嘘言ってすみませんでした。ただし亜種であることは間違いないので、便宜上B+treeということにします。この実装だと内部ノードに実データへのポインタを保存しないため、結果的にブロックに収容されるノード数は多くなり、木の高さを低く抑えることができます。一方でリーフノード同士が接続されていないため現状だと範囲クエリには弱いです。ここは特に制約があってできないわけではなく、単に実装を簡素にしているだけです。
simpledb-goでの実装はこのあたり。全てのノードはキー値と、下位ノードあるいは実データが格納されている場所を持ちます。ノード間の参照をどのように保持するのかという点は競プロや大学の講義で実装する探索木と大きく異なります。メモリ上のデータ構造であれば他のノードへのアドレス(ポインタ)を持てばよいのですが、データベースのインデックスはディスク上に永続化する必要があります。テーブルのデータ量が増えればインデックスもメモリに乗り切らなくなるため、各ノードはメモリ上のポインタではなくディスク上の位置(データファイル上のブロックオフセット+ブロック上のデータスロットオフセット)を保持し、必要なノードだけをディスクからバッファプールに読み込んで辿っていく仕組みになっています。
とりあえずベンチマーク結果
とりあえず10万件のデータに対してベンチマークを実行してみました。ベンチマークツールはid(int), name(varchar(10)), class(varchar(1))のカラムを持つテーブルに10万件INSERTした後、各種CRUD操作の性能を計測します。今回注目するのはベンチマーク後半のインデックス比較部分で、idカラムに対するSELECTを100回実行し、その後idカラムにインデックスを作成して同じSELECTを100回実行するというものです。
なお、simpledb-goではデータをブロック単位でディスクに保存しており、今回のベンチマークでは1ブロック4,000バイト*1(blockSize=4000)で実行しています。また、ディスクから読み込んだブロックはバッファプールにキャッシュされますが、そのサイズは100ブロック分(bufferSize=100)です。このテーブルでは1レコードあたり76バイトを消費する*2ので、1ブロックに収まるのは約52レコード、10万件を格納するには約1,923ブロックが必要になります。バッファプールの100ブロックではテーブル全体の約5%しかキャッシュできないため、フルスキャンではほぼ毎回ディスクアクセスが発生することになります。
そして今回作成したidカラムに対するインデックスはリーフノード1つにつき32バイト*3, 中間ノード1つにつき24バイト*4消費するため、1ブロックあたりリーフで4000/32 = 125個、中間ノードで4000/24 = 166個収容できます。必要なリーフブロックは100000/125 = 800ブロックです。中間ノードは1ブロックあたり166個のエントリを持てるので、800個のリーフブロックを指すには800/166 ≈ 5ブロックの中間ノード層が必要になります。さらにその5ブロックはルートノード1ブロックで十分指せるため、インデックスの木の高さは2となります。
$ RECORDS=100000 ./benchmark
=== SimpleDB Benchmark (mode=all) ===
records=100000  blockSize=4000  bufferSize=100

INSERT                                               14m32.189s  (115 ops/sec)
SELECT full scan (100000 rows)                             26ms
SELECT WHERE name="goat" (10018 rows)                      46ms
UPDATE (10097 rows affected)                              135ms
DELETE (9913 rows affected)                               151ms

--- Index (id) ---

SELECT full scan (100 lookups)                           2.781s  (36 ops/sec)
CREATE INDEX on id                                       3.659s
SELECT with index (100 lookups)                          2.199s  (45 ops/sec)
以上はベンチマークの結果です。インデックスなしが2.781s、インデックスありが2.199s。あまり性能向上していません。INSERTが14分かかっている件も気になりますが、今回はSELECTに集中することにします。
pprofで原因を探る
期待したほどの差が出ない原因を調べるため、Goのpprofを使ってプロファイルを取得してみました。
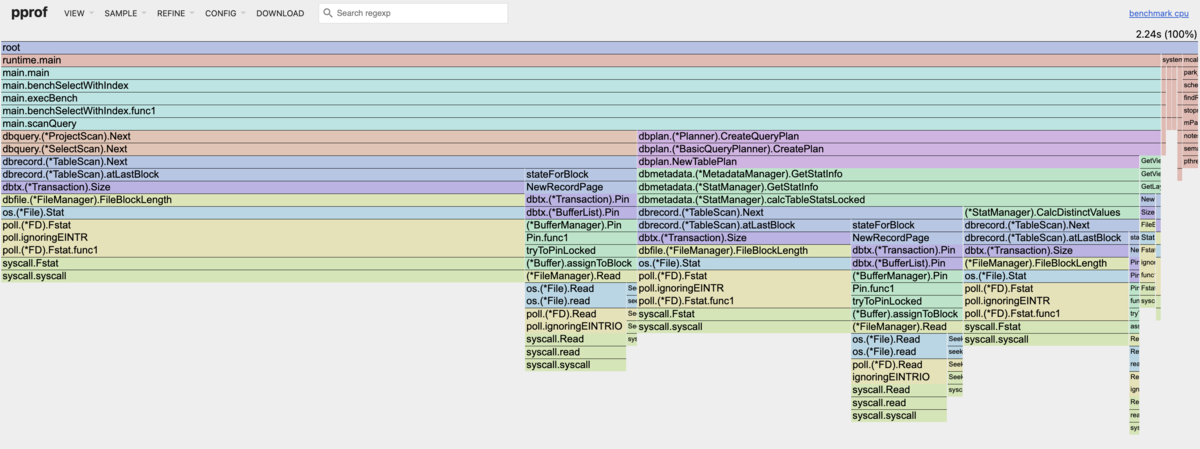
フレームグラフを見ると、上部に横長に広がっているscanQueryのうち、紫色のCreateQueryPlanが全体の4割近くを消費しています。データアクセスそのものはその左にあるNextなので、それに迫るほどクエリプランの作成に時間がかかっているということです。
このクエリプランを作成するのはプランナというコンポーネントの仕事です。今回のような単純なSELECTでもプランナはテーブルの統計情報をもとに実行計画を組み立てます。統計情報とはテーブルの行数やカラムの値の分布といった情報で、たとえばテーブル間のnested loop joinを実行する際は、この統計情報を利用して想定されるブロックアクセス数が少ないテーブルを外部表(左側のテーブル)に設定する、といった使われ方をします(simpledb-goではこの辺)。
今回やたらとクエリプランの作成に時間がかかっている原因を深掘りしてみると、このテーブルの統計情報の取得にバグがあることがわかりました。この統計情報は計算コストが高いので、通常はクエリプランを作成する時に事前計算しておいたものを利用します。もし統計情報が存在していなければそこで初めて構築し、2回目以降はしばらくそのキャッシュを利用するのですが、このバグでは2回目以降もクエリごとに構築されていました。
バグ修正後の再計測
統計情報のバグを修正して、再度計測してみました。ついでにディスクI/Oの回数も記録するようにしてみました。
インデックスなしの場合
SELECT by id (100 lookups)                               1.357s  (74 ops/sec)
disk I/O: read=192402  write=102
インデックスありの場合
SELECT by id (100 lookups)                                 11ms  (9238 ops/sec)
disk I/O: read=9  write=104
劇的な差が生まれました!スループットは74 ops/secから9238 ops/secへと約124倍の向上です。ディスクのread回数を見ても192,402回から9回へと大幅に削減されており、B-treeインデックスにより必要なブロックだけを辿って目的のレコードに到達できていることがわかります。
read回数をもう少し見てみると、インデックスなしの場合は100回のlookupで192,402回のread、つまり1回のlookupあたり約1,924回のディスクアクセスが発生しています。先ほどの計算でテーブル全体が約1,923ブロックだったので、ほぼ一致しています。インデックスがなければスキャナはidがソートされていることもユニークであることも知らないため、該当レコードを見つけても最後までスキャンし続けます。毎回テーブル全体を走査しているわけです。一方インデックスありの場合は100回のlookupでわずか9回です。上述した通りインデックスの高さは2なので、通常は3回のディスクアクセス(インデックスをリーフまで辿るのに2回、実際のデータアクセスに1回)でデータを取得できますが、今回300回のディスクアクセスが発生していないのはバッファプールにキャッシュが効いているためです。
フレームグラフで内部の動きを確認する
もう少し詳しく内部の挙動を見てみます。Goのpprofは100Hzでサンプリングするため、実行時間が短すぎると統計的に意味のあるプロファイルが取れません。そこで1000回のSELECTを実行してプロファイルを取得しました。
まず、インデックスを使わない場合のフレームグラフです。
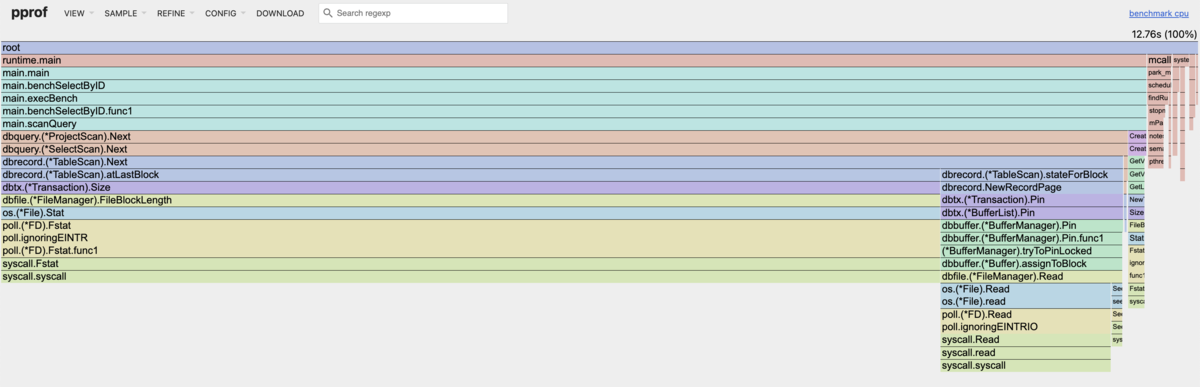
横幅のほとんどをscanQueryとその配下のNext処理が占めています。全ブロックを順番に読んでいくフルスキャンの様子が見て取れます。合計12.76秒かかっています。
次に、インデックスを使った場合のフレームグラフです。
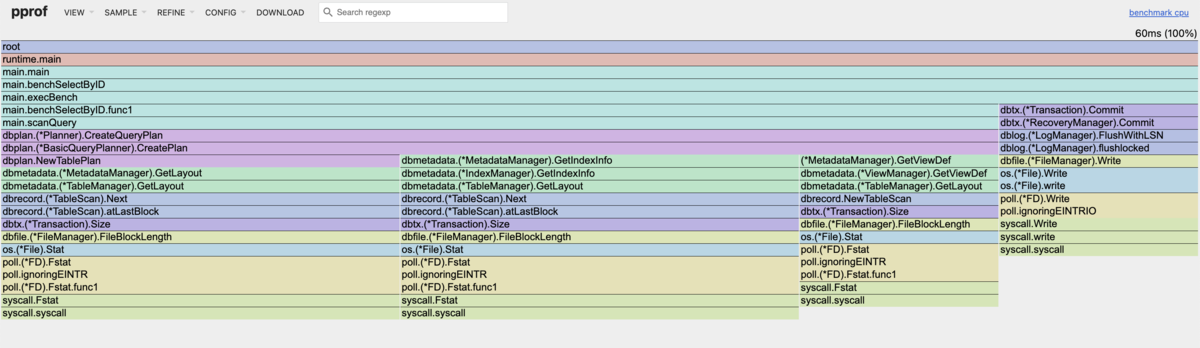
合計60msと桁違いに速くなっています。スキャン処理が大幅に軽くなった一方で、再びCreateQueryPlanが横幅の大きな割合を占めているのが面白いところです。データアクセスが速くなったことで、相対的にクエリプランの作成コストが目立つように変化しています。
おわりに
今回はB-treeインデックスの効果をベンチマークで確かめてみました。コードベースがわかった状態で色々と内部をいじくり回したり、実験したりできるのが自作DBの醍醐味でもあります。
統計情報のバグという思わぬ落とし穴がありましたが、修正後はインデックスの有無で約124倍の性能差が出ることを確認できました。
一方で、インデックスによるデータアクセスが速くなったことでクエリプランの作成がボトルネックとして見えてきました。これに対してはプランをキャッシュする、さらにテーブル定義などを毎回取得しているのをやめてキャッシュをする、といった最適化の余地がありそうです。これはおいおい取り組んでいきたいところです。
さて、次回は冒頭のベンチマークでもみた通り書き込みが遅すぎる問題に切り込みたいと思います。まだ調査できてないですが、いっそのことLSM Treeを使うように大きく書き換えてみる、というのも面白そうだと思っています。
RDBMSをGoで自作した
普段業務で色々なデータベースを触っていると、こいつの中身はどうなっているんだろうと気になることがあります。そんなわけでDatabase Design and Implementation: Second Editionという書籍をもとに、Go言語でRDBMSを自作しました。本書はJavaで書かれていますが、そのまま写経するのは面白くないのでGoでリライトしています。
出来上がったもの:
CREATE TABLE / INDEX / VIEW、SELECT、INSERT、UPDATE、DELETEといった基本的なSQLが実行できます。書籍では終盤GROUP BYやクエリ最適化をする章がありますが、まだ手を付けておらずインデックスまでの実装となっています。
なおAIコーディングエージェント全盛期ですが、この実装は学習目的なのでAIの利用は控えめにしました(テストとかでは使った)。
実装の流れ
本書は基本的にボトムアップで進みます。低レイヤから一つずつ積み上げていく構成です。
chapter 1~3
まずデータベースやディスクといった概念の説明から始まり、DBのデータをブロック単位で読み書きするファイルマネージャの実装に入ります。ページ内の指定オフセットに数値や文字列を書き込んだりするプリミティブなところから実装していきます。TCPを実装した時も思ったのですが、こういうバッファにバイナリ詰めてる時がゼロから自作している感があって好きだったりします。
chapter 4
バッファマネージャとログマネージャを実装します。バッファマネージャはディスクアクセスを減らすためのバッファプールを管理するもので、ログマネージャは操作履歴を記録するものです。ログマネージャは特に次の章のトランザクションと密接に関わってきます。
バッファマネージャの実装を通して、DBMSが如何にしてディスクIOを回避し、メモリ上のバッファプール内で処理を完結させているかを垣間見ることができます。PinやUnpinの処理をLRUにしたりと工夫の余地も大きいところですね。またバッファサイズとページサイズの調整はパフォーマンスチューニングでもよく見る重要項目ですが、どのパラメータを調整しているのか、実装を通してよりイメージがつくようになりました。
chapter 5
トランザクションの実装で、一気にDBMS感が増して面白くなる章です。トランザクションごとの操作の分離、コミット、ロールバック、リカバリの仕組みが詳細に理解できます。読み進めるうちにWAL(Write Ahead Log)が偉大すぎることを改めて実感する章でもあります。ここから実装が一気に複雑になるので、それまでの実装のテストをしっかり書いてバグを潰しておかないと詰むかもしれません。特に非同期処理やロックが絡む部分はそうで、JavaからGoへの移植で一番差が出ることもありテストの重要性は高かったです。この辺りのテストでは最近(でもない?)追加されたGoのsynctestパッケージが役に立ちました。
chapter 6
ブロック内にどうやってレコードを配置するかを考え、レコードマネージャを実装します。SimpleDBは固定長レコードで実装しており、テーブルスキーマ作成時にレコードサイズが決まります。その後のレコード更新で伸びたりしません。実装はシンプルですが、ブロック内に使われない領域ができたり、そもそも文字列を確保分以上は伸ばせなくなるという制約を受けます。
可変長レコードの実装も解説されますが、実装は格段に複雑になります。ページ内のレコード境界が静的に決定できなくなる上、レコードサイズが大きくなった際にページから溢れたり他のレコードを押し出したりする可能性が出てくるからです。移動が発生すれば元の場所を指しているインデックスの更新も必要になることがあるため、変更の影響範囲も大きくなります。商用のDBのほとんどが可変長レコードを採用しているようです。
chapter 7
テーブルスキーマやメモリレイアウトなどを管理するメタデータマネージャを作ります。テーブルやビューの作成ができるようになります。
chapter 8~10
SQLのパーサ、クエリプロセッサ、プランナーを実装します。パーサは単純な再帰下降パーサです。ここまでできればSQLを実行してデータを操作できるようになり、実質RDBMSと呼べるものになります。クエリプロセッサ内のスキャナーは、基本的に先頭から順番にデータを見ていき、WHEREなどで条件があれば評価しつつデータを返していくという単純なものになっています。Nested Loopによる単純なJOINも実装します。
chapter 12
Hash indexとB-Tree indexを実装します。B-Treeは普段DBを扱う人にとっては馴染み深いかと思います。実装は難しいながらも洗練されており、ソートされたノードリストを持つツリーが分割されながら成長していく様子をイメージするのがポイントになります。また前章で作成したプランナーにうまく組み込み、データの取得と挿入時にインデックスが使われるようにする必要もあります。
chapter 13~
未着手ですが、ここを進めるとGROUP BYやORDER BYができたり、クエリが高速化したりするようです。ここは今後おいおいやっていきます。
感想
非常に楽しめましたし学びになりました。最近改めて「詳説データベース」を読み返しているのですが、やはり実装が頭にあると理解度が段違いになります。最初に読んだときはWALやインデックスの説明でふーんそんなもんかと流していた箇所が、自作を経験した後だと鮮明にイメージできるようになりました。また商用DBを扱うときも、パラメータの意味に想いを馳せたりできます。
本記事で紹介したDatabase Design and Implementation: Second Editionですが、DB自作初心者に非常におすすめです。コアとなるロジックの説明がとにかく丁寧で、置いていかれることがありません。一方でコードを読む際は多少のエスパー力が求められる場面もあったりしますが、普段コードを書く人なら問題ないと思います。困ったらAIもありますからね。
DB周りを深掘りしていきたい欲が増したので、今後は作ったsimpledb-goをclient-server構成にしたり、分散データベースにしてみたりと、色々試してみたいところです。
プラットフォームエンジニアリングについてパネルディスカッションを行いました
早いものでもう1ヶ月ほど経ってしまいましたが、5/21にGoogle Cloud様主催のInnovators Live Japanでパネルディスカッションに参加させていただきました。
タイトルとしては「先進企業が語る、Platform Engineering 導入のリアル:成功と課題」ということで、最近話題のプラットフォームエンジニアリングに関して各社の取り組みや実際やってみた課題感などをディスカッションしました。
Ubieでは Ubieにおけるプラットフォームエンジニアリングの取り組み2023 - 電気ひつじ牧場 でも述べたように、最近プラットフォームエンジニアリングを通したプロダクト開発エンジニアの生産性向上に力を入れています。この記事は昨年末に書かれたものであるため、まだ構想段階のものや、その時点で移行が計画されていた将来の基盤に関する情報がいくつか説明されていました。
今回のパネルディスカッションは、今年3月に実施された新基盤への移行を経て、記事中で言及のあるようなtemplate toolやサービスカタログを用いたUbieのプラットフォームについて触れています。それらを活用したサービス構築、運用の改善効果や、プラットフォームエンジニアリングの第一歩としてどのような施策が有効かといった踏み込んだ話まで述べています。(アーカイブが見られるようなので興味ある方は是非)
共にディスカッションさせていただいたメルカリ様、リクルート様はUbieと比較して組織規模が非常に大きいため、そのような組織におけるプラットフォームエンジニアリングの実践方法については非常に学びになりました。
さて、今回ディスカッションした内容についてより踏み込んだ内容を、7/9のPlatform Engineering Kaigiの方で発表させていただきます。ぜひ聴きに来ていただけると嬉しいです。
Ubieにおけるプラットフォームエンジニアリングの取り組み2023
Ubie Engineering Advent Calendar 2023 の22日目の記事では、Ubieのプラットフォームで生じていた課題と、それを解決するためにサービステンプレーティングツールを開発・導入した取り組みについて紹介します。
続きを読むTerraformのvariables.tfを生成するツールを作った
Terraformのvariablesあるある(?)
variablesブロックを変数ごとに書くのがめんどくさい。- 色々インフラの変更をした結果、未使用の
variablesが放置されがち
1つ目に関しては変数の数が増えてきたら特にめんどくさくなります。大体の変数がstringかnumber型なので、variablesブロックも大体同じ感じの定義がずっと続くことになります。
2つ目はtflintを毎回実行して未使用の変数を除去すれば良いのですが、不幸にもそれができていないまま変数が1000個くらいに膨れ上がってしまったプロジェクトもあったりします。
そんなわけでvariables.tfをいい感じに生成してくれるツールを書きました。
できたもの
これがやることはシンプルで、
- 不足している
variablesブロックを追加したvariables.tfを出力する - syncモードの時は、↑に加えてさらに未使用の
variablesブロックも削除する - オプションをつけると、tfvarsファイルも一緒に整理する
例
それぞれ次のように定義されていたとします。
my_resource.tf
resource "my_resource" "myvar" {
  url        = "http://semvar.co.jp/${var.appname}/${var.env}"
  # title      = var.moge
  expiration = var.expiration_days
}
variables.tf
variable "env" {}

variable "unused" {
  description = "my variable"
}

variable "appname" {
  description = ""
}
dev.tfvars
env = "dev"

unused = {
  "abc"  = "def"
  "bird" = "owl"
}

appname = "myapp"
実行結果はこうなります。
$ tfv -sync --tfvars-file dev.tfvars

variable "env" {}

variable "appname" {
  description = ""
}

variable "expiration_days" {
  description = ""
}
使われてないunusedを除去し、定義されていないexpiration_daysを追加したものが出力されます。
また、dev.tfvars.generatedにはこのようなファイルが生成されます。
env = "dev"

appname = "myapp"
できないこと
真面目にパーサを書いてないので、%{}を含む構文には対応していません。つまり、%{}で囲まれているvar.fooのような変数の利用があっても正しく認識されない場合があります。
そもそも%{}をあまり見ないのでこれは何?って感じなんですが、これは文字列の中に制御構文を埋め込む記法です。
公式サイトの例にあがっているのが次のような書き方です。
"Hello, %{ if var.name != "" }${var.name}%{ else }unnamed%{ endif }!"
%{}は再帰的な構造を持つことができるので、行ごとにGoのregexpでパターンマッチする方針だと上手く扱えませんでした。ただ%{}を使うことがあまりないので、大体のケースでなんとかなると思います。
Request is missing Authentication Token: OperationErrorになる
StepFunctionをlambda(Go 1.x)からキックするようなコードを書いてる時に、StartExecutionを呼び出すと次のようなエラーが出た。
operation error SFN: StartExecution, https response error StatusCode: 400, RequestID: xxxx-xxxx-xxx-xxxx, api error MissingAuthenticationTokenException: Request is missing Authentication Token: OperationError
lamdbaのロールを変更してみても解決せず、ggってもそれらしいのが出てこないのでなんだこれってなってた。
続きを読む